제목에 없던 작품명이 검색어 1위가 된 쇼츠 2편: 175만 뷰·104만 뷰 도달범위 기록
유튜브에 영상을 올릴 때마다 설명란 하단에 수십 개의 관련 태그를 빽빽하게 적어 넣고, 해시태그를 종류별로 조합하던 시절이 있었습니다. 검색 결과 상단을 차지하기 위해 제목에 핵심 키워드를 어색하게 반복 배치하거나, 조금이라도 연관 검색어에 걸리기 위해 메타데이터를 채워 넣던 방식은 지난 10년간 유튜브 검색 최적화(SEO)의 정석처럼 여겨졌습니다.
그러나 2026년 들어 유튜브가 AI 기반 검색·추천 기능을 잇따라 공개하면서, 제목과 태그 같은 텍스트 메타데이터의 비중이 예전만큼 크지 않을 수 있다는 논의가 이어지고 있습니다. 이 글은 그 논의를 단정하지 않고, 제 채널의 실제 검색 유입 데이터가 무엇을 보여주는지부터 살펴봅니다.
제 채널에서 지난 6월에 업로드한 2편의 실제 스튜디오 유입 지표를 보여드리고, 공개된 자료로 확인되는 범위와 저의 추정을 구분해서 정리했습니다.
영상으로 한눈에 보기: 태그 없는 175만 뷰와 검색 유입의 비밀
본 포스팅에서 다루는 핵심 분석과 스튜디오 데이터를 영상으로 더 알기 쉽게 정리했습니다. 글을 읽기 전 편하게 시청해 보세요.
공개된 자료로 확인되는 변화, 그리고 확인되지 않는 것
2026년 9월 23일 열린 Made on YouTube 2026에서 유튜브는 Gemini 기반의 대화형 검색 ’Ask YouTube’와, 보고 싶은 영상을 자연어로 설명해 나만의 피드를 만드는 ’Custom Feeds’를 공개했습니다(TechCrunch 보도). Custom Feeds는 올 가을 미국에서 먼저 제공된다고 보도되었습니다. (이 문단은 2026년 10월 5일에 공개 자료를 확인하여 고쳤습니다.)
반면 ‘유튜브 검색이 제목과 태그를 더 이상 보지 않는다’, ’검색 색인 구조가 AI로 완전히 대체되었다’는 주장은 공식 자료로 확인하지 못했습니다. 아래의 스튜디오 데이터는 제목에 없던 작품명 키워드가 실제로 검색 유입 1위를 차지했다는 사실만을 보여줍니다.
Gemini Omni와 유튜브: 확인되는 범위
2026년 5월 19일 Google I/O 2026에서 구글은 영상 생성·편집이 가능한 멀티모달 모델 ’Gemini Omni’를 공개했고, 유튜브에서는 쇼츠 리믹스(Shorts Remix)와 Create 앱에서 이를 쓸 수 있다고 밝혔습니다(9to5Google 정리). 즉 공개된 내용은 ’영상 제작 도구’에 관한 것이며, Gemini Omni가 유튜브 검색 색인에 적용되었다는 공식 발표는 확인되지 않았습니다.
구글이 영상 이해(Video understanding)를 Gemini의 기능으로 제공한다는 점은 공식 문서에서 확인되지만(Google Cloud 문서), 그 기술이 유튜브 검색 순위에 어떻게 쓰이는지는 공개되어 있지 않습니다.
스튜디오 지표: 제목에 없던 ’은교’가 검색 1위를 차지한 2편의 기록
다음은 제목에 없던 작품명이 검색 유입 상위를 차지한, 자체 운영 채널에서 지난 6월 12일과 13일에 업로드했던 2편의 숏폼 드라마 지표입니다. 원인을 단정할 수는 없지만, 제목과 공식 태그에 의존하지 않는 노출이 있었다는 점은 확인됩니다.
1. 43초 쇼츠: [Case A] 캐릭터 명대사 코믹 쇼츠
첫 번째 영상은 2026년 6월 13일에 게시된 43초 길이의 쇼츠입니다. 제목은 ’[Case A] 캐릭터 명대사 코믹 쇼츠 (43초)’으로 설정되었습니다. 제목과 공식 태그(Tags) 설정란 어디에도 영화 제목(‘은교’)이나 배우들의 이름은 적지 않았으며, 설명란 하단에 짧게 영화 #은교 #김무열 #박해일 #김고은 해시태그만 기재해 둔 상태였습니다.

스튜디오의 세부 참여도 수치는 이렇습니다.
- 유효 조회수: 175.7만 회
- 순 시청자수: 162.9만 명
- 시청 시간: 2.2만 시간
- 평균 시청 지속 시간: 0:43 / 0:43 (완주율 100%)
- 피드 참여도: 계속 시청함 73.7% / 이탈함 26.3%
43초 전체를 완벽하게 시청하게 만드는 높은 리텐션으로 175만 뷰를 달성한 이 영상의 도달범위 탭을 열었을 때, 검색 유입어에서 매우 흥미로운 현상이 발견되었습니다.

유튜브 검색창으로 유입된 시청자들의 검색어 분포입니다.
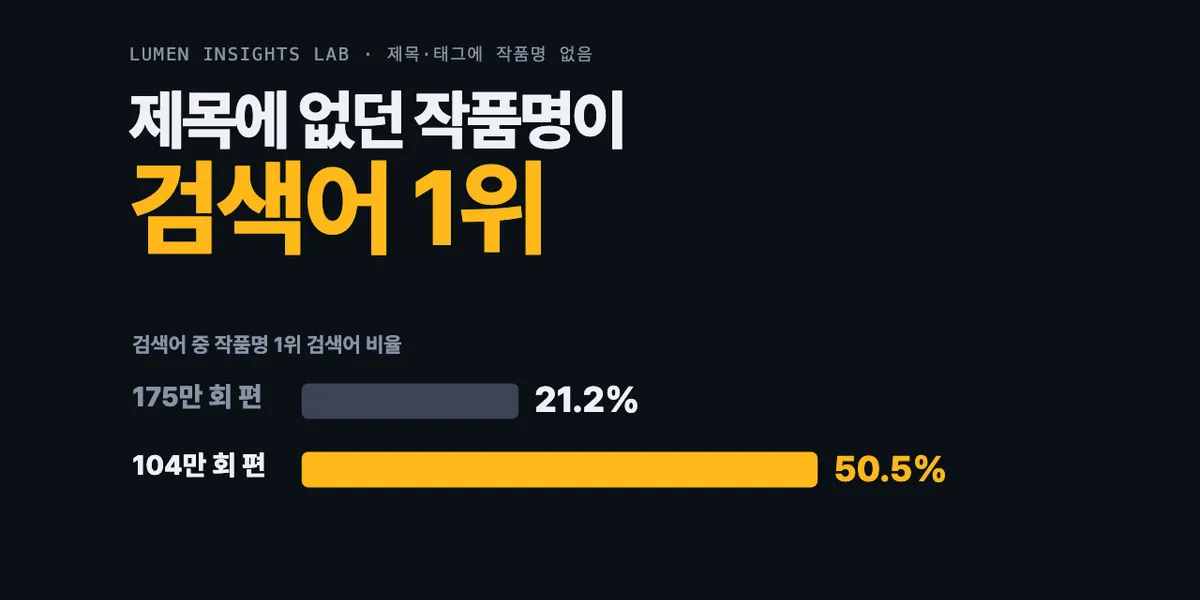
- 은교: 21.2% (1위)
- 은교 김고은 명장면: 1.1%
- 은교 김무열: 1.0%
- 김무열 은교: 0.9%
- 은교 김고은 김무열: 0.7%
제목에는 상황 묘사만 존재했고 공식 태그 설정도 비어 있었음에도, 유입 검색어의 상위 5개는 100% 영화 ’은교’와 출연 배우들의 이름으로 채워져 있었습니다.
2. 44초 쇼츠: [Case B] 감성 로맨스 명장면 쇼츠
두 번째 기록은 하루 앞선 2026년 6월 12일에 게시된 44초 길이의 두 번째 쇼츠에서 나타났습니다. 제목은 ’[Case B] 감성 로맨스 명장면 쇼츠 (44초)’이었습니다.

- 유효 조회수: 104.7만 회
- 순 시청자수: 96.9만 명
- 시청 시간: 1.3만 시간
- 평균 시청 지속 시간: 0:43 / 0:44 (완주율 97.7%)
- 피드 참여도: 계속 시청함 82.4% / 이탈함 17.6%
이 영상 역시 100만 회가 넘는 높은 조회수를 기록했는데, 도달범위에서는 검색 유입 비중이 눈에 띄게 높았습니다.

- Shorts 피드 유입: 89.8%
- YouTube 검색 유입: 8.6%
- YouTube 검색어 1위: 은교 50.5%
- 은교 김고은 명장면: 7.4%
- 김고은 은교: 5.6%
- 은교 김고은: 4.9%
- 은교 김고은 김무열: 2.1%
같은 채널에서 258만 회까지 간 다른 쇼츠는 검색 유입이 1.6%였습니다. 이 영상은 전체 트래픽의 무려 8.6%(누적 9만 회 이상)가 순수 유튜브 검색으로 유입되었습니다. 더욱 놀라운 사실은 검색창으로 들어온 시청자의 절반이 넘는 50.5%가 ’은교’라는 단어를 입력해 이 영상을 찾아냈다는 점입니다.
여기서 한 가지 의문이 생길 수 있습니다. “설명란에 #은교 해시태그를 포함했으니 검색에 걸린 것이 당연하지 않은가?“라는 점입니다.
해시태그가 작용했을 수 있습니다. 다만 제목에 작품명이 없는데도 검색어의 절반이 작품명이었다는 점은 제가 예상한 것보다 컸습니다.
한 가지 가설은 ’교차 검증’입니다. 설명란의 #은교라는 텍스트 단서가 영상 속 실제 대사와 일치했기 때문에 검색에 잘 노출되었을 수 있습니다. 다만 이것이 AI의 영상 분석 때문인지, 자동 생성 자막(STT)과 해시태그 같은 기존 신호의 조합 때문인지는 이 데이터만으로 구분할 수 없습니다.
AI 비디오 파이프라인 아키텍처: 프레임과 음성이 검색 엔진으로 변환되는 과정
※ 아래 도식은 공개된 Gemini 영상 이해 문서와 제 채널 데이터를 바탕으로 그린 추정 모델입니다. 유튜브가 공개한 실제 검색 구조가 아닙니다.
다음은 영상 속 음성과 화면을 함께 이해하는 시스템이 있다고 가정했을 때의 개념도입니다.
flowchart TD
    subgraph Input["업로드 미디어 입력"]
        V["비디오 프레임 시퀀스 (FPS 샘플링)"]
        A["오디오 음성 파형 (배경음 분리)"]
    end

    subgraph Multimodal["Gemini 멀티모달 비디오 엔진"]
        direction TB
        V_Enc["시각 특징 추출기 (Visual Encoder)<br/>인물 얼굴 / 주변 사물 / 온스크린 자막"]
        A_Enc["음성 특징 추출기 (Audio Encoder)<br/>대사 딕션 / 화자 분리 / 억양 분석"]
        Cross["크로스 어텐션 융합 (Cross-Modal Fusion)<br/>시각-청각 일치성 및 맥락 추론"]
        V_Enc --> Cross
        A_Enc --> Cross
    end

    subgraph Knowledge["지식 그래프 및 메타데이터 생성"]
        Entity["고유 개체 (Entity) 식별<br/>작품명: 은교 / 배우: 김고은, 박해일"]
        Topic["주제 및 씬 세그먼트 (Scene Embedding)<br/>문학적 감성 토론 / 명대사 하이라이트"]
        Entity --> Topic
    end

    subgraph Serving["유튜브 검색 및 추천 서빙"]
        SERP["유튜브 검색 결과 (SERP)<br/>키워드 일치 없이 개체 기반 노출"]
        Ask["Ask YouTube 대화형 검색<br/>질문 맞춤형 쇼츠 구간 다이렉트 추천"]
        Feed["Custom Feeds 및 탐색 추천"]
    end

    Input --> Multimodal
    Cross --> Knowledge
    Topic --> Serving

    classDef dark fill:#1e1e24,stroke:#4f46e5,stroke-width:2px,color:#fff;
    classDef highlight fill:#312e81,stroke:#818cf8,stroke-width:2px,color:#fff;
    class V,A,Entity,Topic dark;
    class Cross,SERP,Ask,Feed highlight;
이 가정에서는 영상이 업로드되면 시각과 청각 정보가 분리되어 각각 분석됩니다. 시각 인코더는 프레임 단위로 배우의 이목구비, 의상, 화면에 타이핑된 자막을 읽어 들이고, 오디오 인코더는 배경음악 뒤에 숨겨진 실제 대사를 음소 단위로 추출합니다.
두 정보가 결합되어 하나의 개체(Entity)로 정리된다면, 화면에 배우의 얼굴이 나오고 오디오에서 ’은교’라는 대사가 확인되는 순간 영상에 ’은교’라는 주제 정보가 자동으로 부여될 수 있습니다. 이런 구조라면 시청자가 ’은교’를 검색했을 때 제목과 무관하게 이 영상이 노출되는 현상을 설명할 수 있습니다. 다만 이는 가설입니다.
이 기록을 보고 제가 바꾼 제작 습관
아래는 위의 두 영상과 가설을 바탕으로 제가 바꾼 습관입니다.
효과를 따로 재 본 것은 아니고, 공식 확인된 방법도 아닙니다.
1. 첫 대사를 또렷하게 들리게 하기
배경음악이 첫 대사를 덮지 않도록 음량을 정리합니다.
영상이 다루는 인물이나 작품을 알 수 있는 대사가 있다면 앞쪽에 둡니다.
검색이 음성을 얼마나 쓰는지는 공개되어 있지 않습니다.
다만 시청자에게도 첫 대사가 또렷한 편이 상황을 빨리 알아듣습니다.
2. 화면 자막으로 주제를 분명히 하기
음성만으로 고유명사가 전달되기 어려우면 화면 상단이나 중앙에 자막으로 적습니다.
무음으로 넘겨 보는 시청자에게도 같은 효과가 있습니다.
3. 제목과 본편을 맞추기
제목이나 썸네일에 적은 내용을 본편에서 다루지 않으면 시청자가 금방 나갑니다.
태그를 오래 고민하기보다 제목과 본편이 같은 이야기를 하는지 먼저 확인합니다.
이 글의 영상은 설명란에 작품명 해시태그를 넣어 둔 영상이었습니다.
무엇이 실제로 작용했는지는 가릴 수 없으니, 해시태그와 설명란도 그대로 챙깁니다.